Definition: Datenklassifizierung ordnet Informationen nach ihrem Schutzbedarf in Stufen ein, etwa öffentlich, intern, vertraulich und streng vertraulich. Für KI legt die Klassifizierung fest, welche Daten an welches Sprachmodell gegeben werden dürfen und ob ein Modell in der Cloud, in einer souveränen Cloud oder im eigenen Rechenzentrum laufen muss.
Die Frage, welche Daten in KI-Tools eingegeben werden dürfen, stellt sich in jedem Unternehmen, das KI breit einführt. Viele beantworten sie mit einer Richtlinie: keine Kundendaten, keine Personaldaten, keine Geschäftsgeheimnisse in öffentliche Dienste. Im Alltag reicht das selten aus, weil Mitarbeitende nicht bei jedem Dokument entscheiden können, welcher Klasse es angehört, und weil eine Richtlinie die Eingabe nicht verhindert. Wie verbreitet die ungesteuerte Nutzung ist, beschreibt unser Beitrag zu Shadow AI als Compliance-Risiko.
Dieser Artikel zeigt, wie eine Datenklassifizierung für KI aufgebaut ist, welche Stufen sich bewährt haben, wie Daten klassifiziert werden und wie die Klassifizierung technisch durchgesetzt wird.
Was bedeutet Datenklassifizierung?
Datenklassifizierung ist die Einordnung von Informationen nach Schutzbedarf. Sie ist seit Langem Teil der Informationssicherheit: ISO/IEC 27001 verlangt in Anhang A, Informationen nach Schutzbedarf zu klassifizieren und zu kennzeichnen, und der BSI-Standard 200-2 sieht eine Schutzbedarfsfeststellung mit den Kategorien normal, hoch und sehr hoch vor. Behörden kennen zusätzlich die Einstufung von Verschlusssachen.
Mit KI erhält die Klassifizierung eine neue Aufgabe. Sie entscheidet darüber, welcher Verarbeitungsweg für eine Anfrage zulässig ist. Ein Sprachmodell eines US-Anbieters, ein offenes Modell in einer souveränen Cloud und ein lokales Modell im eigenen Rechenzentrum haben unterschiedliche Risiken, etwa beim Zugriff durch ausländische Behörden oder bei der Weiterverwendung von Eingaben. Die Klassifizierung verbindet jede Datenart mit den zulässigen Wegen.
Welche Klassifizierungsstufen gibt es?
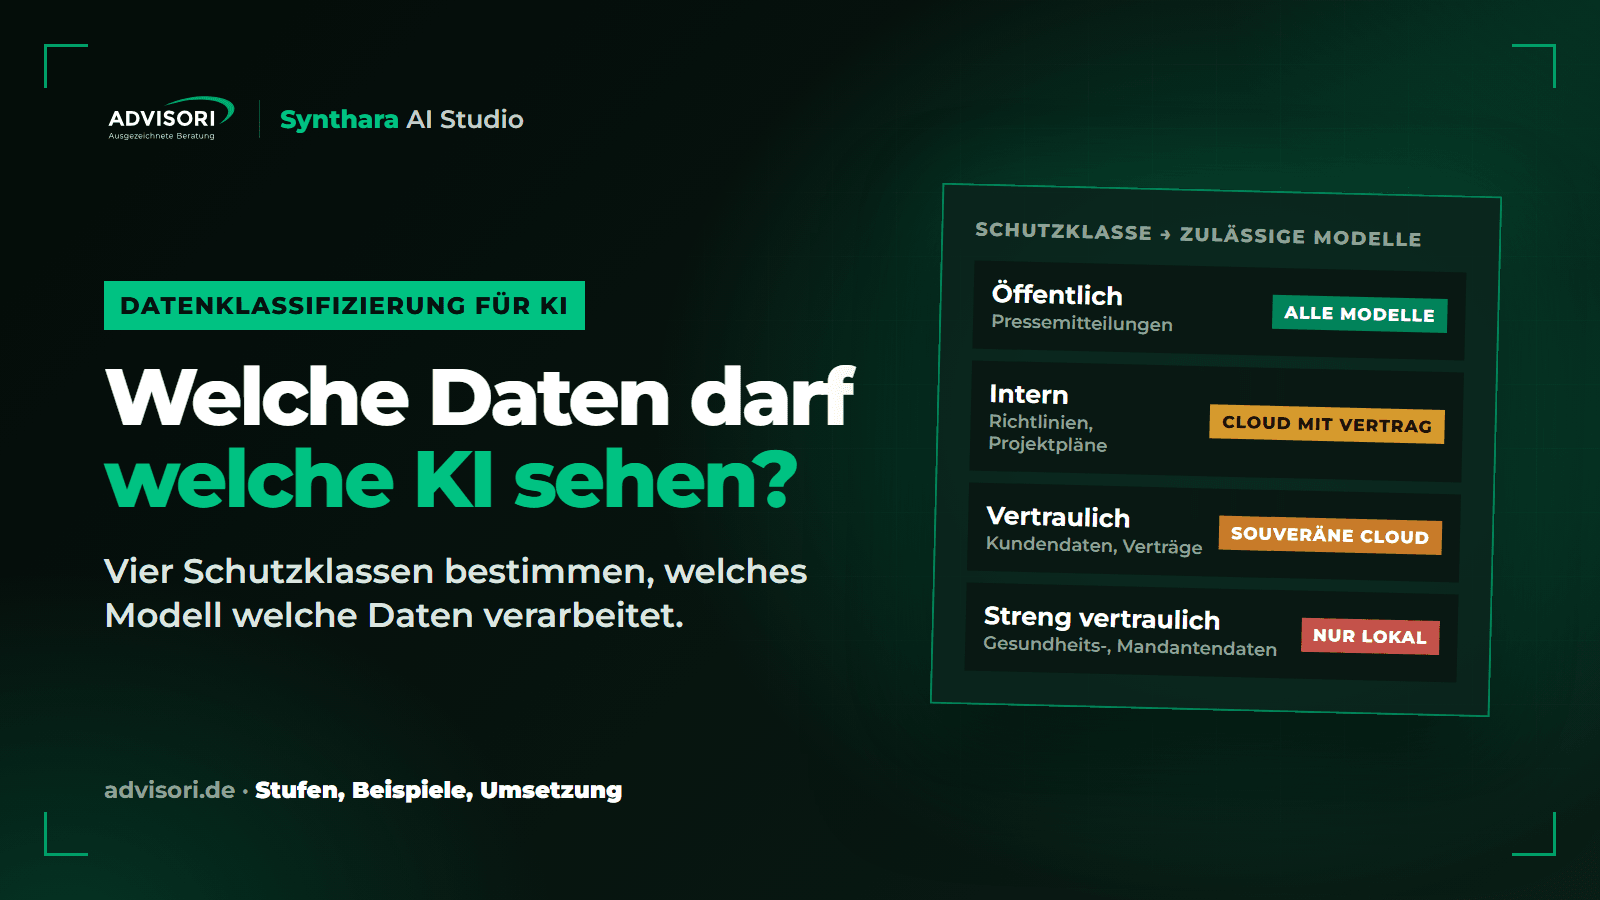
Die meisten Unternehmen arbeiten mit vier Stufen. Für KI hat sich eine Zuordnung zu Betriebsorten bewährt:
- Öffentlich: Beispiele: Pressemitteilungen, veröffentlichte Produktinformationen; Zulässige Modelle: alle freigegebenen Modelle, auch Frontier-Modelle in der Cloud
- Intern: Beispiele: Organigramme, interne Richtlinien, Projektpläne ohne Kundenbezug; Zulässige Modelle: freigegebene Cloud-Modelle mit Auftragsverarbeitung und ohne Training auf Kundendaten
- Vertraulich: Beispiele: Kundendaten, Verträge, Kalkulationen, Personaldaten; Zulässige Modelle: Modelle in einer souveränen Cloud oder im eigenen Rechenzentrum
- Streng vertraulich: Beispiele: Gesundheitsdaten, Mandantendaten, Konstruktionsdaten, Verschlusssachen; Zulässige Modelle: ausschließlich lokale Modelle im eigenen Rechenzentrum
Die Tabelle ist ein Ausgangspunkt. Manche Unternehmen nutzen drei oder fünf Stufen oder Kürzel wie C1 bis C4. Regulierte Branchen ergänzen eigene Kategorien, etwa Gesundheitsdaten nach Art. 9 DSGVO bei Versicherungen, Berufsgeheimnisse nach § 203 StGB in Kanzleien und Steuerberatungen oder Forschungsdaten mit Auflagen von Fördergebern. Die Universität zu Köln etwa hat für ihre KI-Nutzung vier Vertraulichkeitsklassen festgelegt und für die höchste Klasse derzeit kein KI-System zugelassen.
Wie Daten klassifiziert werden: manuell, regelbasiert, KI-gestützt
Für die Einordnung gibt es drei Verfahren, die sich in der Praxis ergänzen:
- Manuell: Verantwortliche ordnen Datenquellen, Ablagen oder Dokumente selbst einer Stufe zu. Das ist genau, aber aufwendig und bei großen Datenbeständen kaum durchzuhalten.
- Regelbasiert: Muster wie IBAN, Steuer-ID, Gesundheitsbegriffe oder Vertragsnummern lösen eine Einstufung aus. Regeln sind nachvollziehbar, erkennen aber keinen Kontext.
- KI-gestützt: Sprachmodelle und Klassifikatoren erkennen Inhalte im Zusammenhang, etwa ob ein Dokument eine Kalkulation oder eine Personalakte ist, und schlagen eine Stufe vor.
Bei KI-gestützter Klassifizierung gilt eine einfache Regel: Das Modell, das klassifiziert, muss die Daten vollständig lesen. Es sollte deshalb lokal oder in einer Umgebung laufen, die für die höchste vorkommende Stufe zugelassen ist. Außerdem braucht es eine Qualitätsprüfung. Lassen Sie Verantwortliche eine Stichprobe der Vorschläge bestätigen und messen Sie, wie oft vertrauliche Inhalte zu niedrig eingestuft werden. Diese Fehlerquote ist wichtiger als die Gesamtgenauigkeit.
Warum die Klassifizierung bis auf Feldebene reichen sollte
Eine Klassifizierung je Dokument oder je System ist für KI zu grob. Ein CRM enthält öffentliche Firmennamen, interne Notizen und vertrauliche Konditionen in einem Datensatz. Wird das gesamte System als vertraulich eingestuft, dürfen auch harmlose Auswertungen nur über lokale Modelle laufen. Wird es als intern eingestuft, gelangen Konditionen an Cloud-Modelle.
Eine Klassifizierung auf Feldebene löst dieses Problem. Jedes Feld einer Datenquelle erhält seine Schutzklasse, und die KI-Plattform entscheidet bei jeder Anfrage anhand der tatsächlich verwendeten Felder, welches Modell zulässig ist. So bleiben mehr Anwendungsfälle möglich, und vertrauliche Inhalte erreichen trotzdem nur geeignete Modelle.
Auch KI-Ergebnisse brauchen eine Schutzklasse
Ein oft übersehener Punkt: Die Antwort eines KI-Assistenten kann vertrauliche Inhalte aus mehreren Quellen zusammenführen. Eine Zusammenfassung von drei internen Dokumenten und einem Vertrag ist so schutzbedürftig wie der Vertrag. Bewährt hat sich die Regel, dass ein Ergebnis die höchste Schutzklasse seiner Quellen erbt. Das gilt besonders für Wissensassistenten, die Antworten aus Dokumentenablagen erzeugen, und für Agenten, die Ergebnisse in andere Systeme schreiben. Wird die Klasse nicht weitergegeben, kann eine vertrauliche Zusammenfassung in der nächsten Anfrage an ein Cloud-Modell gelangen.
Das Ampelmodell für Mitarbeitende
Für die tägliche Arbeit mit KI-Assistenten hilft eine einfache Regel, die Mitarbeitende ohne lange Schulung anwenden können:
- Grün: öffentliche und interne Informationen ohne Personen- oder Kundenbezug. Nutzung in allen freigegebenen KI-Werkzeugen.
- Gelb: Informationen mit Kunden-, Personen- oder Vertragsbezug. Nutzung nur in der freigegebenen Unternehmensplattform, die Daten an zulässige Modelle leitet.
- Rot: Gesundheitsdaten, Mandanten- und Berufsgeheimnisse, Konstruktions- und Verschlusssachen. Nutzung nur in Anwendungen, die ausdrücklich für diese Klasse freigegeben sind und lokale Modelle verwenden.
Das Ampelmodell ersetzt die Klassifizierung nicht. Es übersetzt sie in eine Regel, die im Arbeitsalltag funktioniert, solange die Plattform die Einhaltung technisch absichert.
Datenklassifizierung und DSGVO
Datenklassifizierung und Datenschutz greifen ineinander, sind aber nicht dasselbe. Die Klassifizierung beschreibt den Schutzbedarf einer Information, die DSGVO regelt, ob und wie personenbezogene Daten verarbeitet werden dürfen. Drei Punkte verbinden beides:
- Besondere Kategorien: Gesundheitsdaten, biometrische Daten oder Angaben zur Gewerkschaftszugehörigkeit nach Art. 9 DSGVO gehören in die höchste Stufe und sollten in der Klassifizierung gesondert gekennzeichnet werden.
- Datenschutz-Folgenabschätzung: Wer personenbezogene Daten in größerem Umfang mit KI verarbeitet, muss prüfen, ob nach Art. 35 DSGVO eine Folgenabschätzung erforderlich ist. Die Klassifizierung der beteiligten Datenfelder ist dafür eine wichtige Grundlage.
- Pseudonymisierung: Werden Namen und Kennungen vor der Verarbeitung ersetzt, kann eine Anfrage eine niedrigere Stufe erreichen. Pseudonymisierte Daten bleiben nach der DSGVO allerdings personenbezogen.
Wie Unternehmen Sprachmodelle datenschutzkonform im eigenen Haus betreiben, zeigt unser Leitfaden zu DSGVO-konformer KI mit On-Premise-LLMs.
Beispiel: Vertriebsassistent mit CRM-Zugriff
Ein Vertriebsleiter bittet den KI-Assistenten, den Termin mit einem Bestandskunden vorzubereiten. Die Anfrage berührt vier Felder im CRM: Firmenname und Branche (öffentlich), Gesprächsnotizen (intern), Rabattkonditionen (vertraulich) und die private Mobilnummer des Ansprechpartners (vertraulich, personenbezogen).
Mit einer Klassifizierung je System müsste die Plattform die gesamte Anfrage entweder an ein lokales Modell geben oder die Konditionen an ein Cloud-Modell weiterreichen. Mit einer Klassifizierung auf Feldebene erkennt sie, dass vertrauliche Felder beteiligt sind, und leitet die Anfrage an ein Modell in der souveränen Cloud oder im eigenen Rechenzentrum. Die Mobilnummer wird für die Aufgabe nicht benötigt und bleibt außen vor. Die Antwort erhält die Stufe „vertraulich“ und wird nur in Anwendungen weiterverwendet, die für diese Stufe freigegeben sind.
Was eine Richtlinie zur Datenklassifizierung enthalten sollte
- Stufen mit Definition und Beispielen aus dem eigenen Unternehmen,
- zulässige Modelle und Betriebsorte je Stufe,
- Verantwortliche für die Einstufung je Datenquelle,
- Regeln für KI-Ergebnisse und für Daten, die zwischen Systemen wandern,
- Vorgehen bei Ausnahmen und wer sie genehmigen darf,
- Prüfintervalle und Umgang mit Fehleinstufungen,
- Übersetzung in eine einfache Regel für Mitarbeitende, etwa das Ampelmodell.
Datenklassifizierung in fünf Schritten einführen
- Stufen festlegen: Definieren Sie vier Stufen und die zulässigen Betriebsorte je Stufe. Beziehen Sie Datenschutz, Informationssicherheit und Fachbereiche ein.
- Datenquellen erfassen: Listen Sie die Systeme auf, die an KI angebunden werden sollen, etwa ERP, CRM, DMS, Fileserver und Ticketsysteme.
- Felder klassifizieren: Ordnen Sie den Feldern der wichtigsten Datenquellen ihre Stufe zu. Beginnen Sie mit den Quellen der ersten Anwendungsfälle und nutzen Sie KI-gestützte Vorschläge mit Bestätigung durch Verantwortliche.
- Durchsetzung technisch verankern: Die KI-Plattform prüft bei jeder Anfrage, welche Klassen beteiligt sind, und leitet die Anfrage nur an zulässige Modelle.
- Nachweise führen: Jede Entscheidung wird protokolliert. Datenkatalog und Verarbeitungsverzeichnis zeigen, welche Daten in welche Anwendung fließen.
Die organisatorische Einbettung, also Freigaben, Register und Änderungskontrolle, beschreibt unser Artikel KI-Governance umsetzen.
Woran Sie eine geeignete Software erkennen
Werkzeuge zur Datenklassifizierung gibt es als Teil großer Office- und Sicherheitsplattformen, als eigenständige Lösungen und als Funktion von KI-Plattformen. Für den KI-Einsatz sind fünf Kriterien entscheidend:
- Granularität: Frage an den Anbieter: Lassen sich einzelne Felder einer Datenquelle klassifizieren oder nur Dateien?
- Durchsetzung: Frage an den Anbieter: Bestimmt die Klasse technisch, welches Modell eine Anfrage verarbeitet, oder nur eine Kennzeichnung?
- Vererbung: Frage an den Anbieter: Erhalten KI-Ergebnisse die Klasse ihrer Quellen?
- Ort der Klassifizierung: Frage an den Anbieter: Läuft die automatische Klassifizierung lokal oder in einer Cloud außerhalb Ihrer Kontrolle?
- Nachweis: Frage an den Anbieter: Werden Entscheidungen protokolliert und für Datenschutz und Revision auswertbar gemacht?
Datenklassifizierung mit Synthara AI Studio
In Synthara AI Studio ist die Datenklassifizierung der erste Schritt der Regelkette:
- Angebundene Daten werden bis auf die Ebene einzelner Felder einer Schutzklasse zugeordnet; personenbezogene Felder werden gesondert gekennzeichnet.
- Die Schutzklasse bestimmt mit, welche Modelle und Verarbeitungswege zulässig sind. Verlangt eine Anfrage eine höhere Schutzklasse, leitet die Plattform auf ein höher eingestuftes Modell um und sperrt, wenn keines passt.
- Leitplanken prüfen Eingaben, Ausgaben und Aktionen auf personenbezogene Daten, Prompt Injection und Abfluss von Inhalten. Ein unzulässiger Verarbeitungsweg wird abgewiesen, bevor Daten das System verlassen.
- Eine Ausnahme für einen Datenweg kann nur die für Informationssicherheit verantwortliche Rolle erteilen.
- Ein Datenkatalog mit Schutzklassen und Herkunft sowie Verarbeitungsverzeichnis und Datenschutz-Folgenabschätzung stehen dem Datenschutz zur Verfügung.
Mitarbeitende müssen dadurch nicht bei jeder Frage selbst entscheiden, welches Modell zulässig ist. Die Plattform setzt die Regel durch, die das Unternehmen festgelegt hat. Die rechtliche Bewertung einer Datenquelle bleibt dabei Aufgabe Ihres Hauses.
Häufige Fragen zur Datenklassifizierung für KI
Was bedeutet Datenklassifizierung?
Datenklassifizierung ist die Einordnung von Informationen nach ihrem Schutzbedarf in Stufen wie öffentlich, intern, vertraulich und streng vertraulich. Sie bestimmt, wer auf Daten zugreifen darf und wie sie verarbeitet, gespeichert und weitergegeben werden. Für KI legt sie zusätzlich fest, welche Sprachmodelle und Betriebsorte für eine Anfrage zulässig sind.
Welche Klassifizierungsstufen gibt es?
Üblich sind vier Stufen: öffentlich, intern, vertraulich und streng vertraulich, manchmal als C1 bis C4 bezeichnet. Manche Unternehmen nutzen drei oder fünf Stufen. Entscheidend ist, dass jede Stufe mit klaren Regeln verbunden ist, für KI insbesondere mit den zulässigen Modellen und Betriebsorten.
Welche Daten dürfen in KI-Tools eingegeben werden?
Öffentliche und interne Informationen ohne Personen- oder Kundenbezug dürfen in der Regel in freigegebene KI-Werkzeuge. Kunden-, Personal- und Vertragsdaten gehören nur in eine Unternehmensplattform mit Auftragsverarbeitung und kontrollierten Modellen. Gesundheits-, Mandanten- und Konstruktionsdaten erfordern lokale Modelle im eigenen Rechenzentrum. Im Zweifel gilt die höhere Stufe.
Brauchen wir für KI eine neue Klassifizierung?
In den meisten Fällen lässt sich die bestehende Klassifizierung aus der Informationssicherheit weiterverwenden. Ergänzt werden die zulässigen Modelle und Betriebsorte je Stufe, Regeln für KI-Ergebnisse sowie eine Klassifizierung auf Feldebene für die Datenquellen, die an KI angebunden werden. Eine zweite, parallele Klassifizierung nur für KI sollten Sie vermeiden.
Kann KI selbst Daten klassifizieren?
Ja. KI kann Dokumente und Felder automatisch einordnen, etwa anhand von Personendaten oder Vertragsinhalten, und erkennt dabei auch Zusammenhänge, die feste Regeln übersehen. Die Vorschläge sollten Verantwortliche stichprobenartig bestätigen, und die Klassifizierung selbst sollte mit lokalen Modellen erfolgen, weil sie die Daten vollständig lesen muss.
Was ist der Unterschied zwischen Datenklassifizierung und Schutzbedarfsfeststellung?
Die Schutzbedarfsfeststellung nach BSI-Standard 200-2 bewertet, wie schwer ein Schaden bei Verletzung von Vertraulichkeit, Integrität oder Verfügbarkeit wäre, und ordnet ihn als normal, hoch oder sehr hoch ein. Die Datenklassifizierung ordnet einzelne Informationen einer Stufe zu und verbindet sie mit konkreten Regeln, etwa zulässigen KI-Modellen.
Welche Klasse hat eine KI-Antwort?
Eine KI-Antwort sollte die höchste Schutzklasse der Quellen erhalten, aus denen sie entstanden ist. Fasst ein Assistent interne Dokumente und einen vertraulichen Vertrag zusammen, ist die Zusammenfassung vertraulich. Ohne diese Vererbung können vertrauliche Inhalte über den Umweg einer Antwort an ungeeignete Modelle gelangen.
Fazit
Datenklassifizierung ist die Grundlage dafür, dass Unternehmen KI breit einsetzen können, ohne vertrauliche Daten an ungeeignete Modelle zu geben. Vier Stufen, eine Zuordnung zu Betriebsorten, eine Klassifizierung auf Feldebene und klare Regeln für KI-Ergebnisse schaffen den Rahmen. Wirksam werden diese Regeln, wenn die KI-Plattform sie bei jeder Anfrage durchsetzt und protokolliert.
Live-Demo: Wir zeigen Ihnen in 30 Minuten, wie Schutzklassen auf Feldebene in Synthara AI Studio bestimmen, welches Modell Ihre Daten verarbeitet. Termin direkt in Calendly buchen
Quellen
- ISO/IEC 27001:2022, Anhang A, Maßnahmen 5.12 (Klassifizierung von Informationen) und 5.13 (Kennzeichnung von Informationen)
- BSI-Standard 200-2, IT-Grundschutz-Methodik, Kapitel Schutzbedarfsfeststellung (Kategorien normal, hoch, sehr hoch)
- Verordnung (EU) 2016/679 (DSGVO), Art. 9 und Art. 35
- Sicherheitsüberprüfungsgesetz (SÜG), § 4 (Verschlusssachen und Geheimhaltungsgrade)
- Universität zu Köln, ITCC: Vertraulichkeitsklassen für Informationen im KI-Kontext, https://itcc.uni-koeln.de/services/software/kuenstliche-intelligenz/vertraulichkeitsklassen-fuer-informationen-im-ki-kontext, abgerufen 09.11.2026
Weiterführende Artikel
*Stand: November 2026.*
Souveräne KI · ADVISORI
Frontier-KI auf europäischer Infrastruktur
Frontier-Performance, vollständig in Europa und unter europäischem Recht: als lokale Sprachmodelle in Ihrer Infrastruktur oder orchestriert über Synthara AI Studio.
- EU-Inferenz: kein CLOUD Act, kein Kill-Switch
- DSGVO-konform auf europäischer Hardware
- Live in wenigen Wochen, ohne Vendor-Lock-in